
Sqlde başka bir serverdaki procedure'u vs. openquery ile çağırırken şu hatayı alırsak;
The OLE DB provider "SQLNCLI10" for linked server "LinkedServer" supplied inconsistent metadata for a column. The name was changed at execution time.
yapmamız gereken, openquery ile çalıştırdığımız procedure sorgusuna SET FMTONLY OFF sorgusunu eklemek olmalı. Sonuç olarak, procedure'u execute ederken;
SELECT * FROM OPENQUERY('LinkedServer','SET FMTONLY OFF EXEC Procedureİsmi')
Sql etiketine sahip kayıtlar gösteriliyor. Tüm kayıtları göster
Sql etiketine sahip kayıtlar gösteriliyor. Tüm kayıtları göster
25 Ocak 2012 Çarşamba

30 Ekim 2011 Pazar
Sql RPC Mesajı
Sqlde geliştirme yaparken şu tarz bir hata mesajı alırsanız,

Server 'ServerName' is not configured for RPC.
,yapmamız gereken çok basit bir işlem var demektir. Object Explorer üzerinden hangi server üzerinden RPC hatası verdiyse o server'in linked server properties'ine gelip Server Options tabından, RPC Out özelliğini true yapmalıyız.

23 Ekim 2011 Pazar
Sql'de Recompile
Sql'de Stored Procedure yazarken arka planda üç temel iş gerçekleşir. Bunlar Parsing,Compiling ve Executing'dir. Kısaca neler olduklarını açıklamak gerekirse,
Parsing, yazdığımız kodun syntax olarak hata içerip içermediğinin kontrol zamanıdır,
Compiling, yazdığımız prosedürün execution planını oluşturup bunu geçici hafızaya atılma zamanıdır,
Executing ise anlaşılacağı üzere kodun çalıştığı anda DML'e bildirilen zamandır.
İşte compiling zamanında execution plan'ın hafızaya atılması bazı durumlarda kodumuza hız katabilir. Fakat bazı durumlarda da tablo yapıları veya indeksler çok sık değiştiğinden bu hafızaya atılan execution plan'lar yarar yerine zarar getirir. Bunu nasıl anlarız? ilk derlemede prosedürümüz hızlı çalışıp, sonraki çalıştırmalarda gözle görülür bir yavaşlama varsa, nedeni bu olabilir. Bundan kaçınmak için yapmamız gereken RECOMPILE keyword'unu prosedüre tanıtmak. Kısaca kullanılışı;
Böylece Recompile yazarak, artık execution plan'ın hafızaya atılmasını engelledik.
Parsing, yazdığımız kodun syntax olarak hata içerip içermediğinin kontrol zamanıdır,
Compiling, yazdığımız prosedürün execution planını oluşturup bunu geçici hafızaya atılma zamanıdır,
Executing ise anlaşılacağı üzere kodun çalıştığı anda DML'e bildirilen zamandır.
İşte compiling zamanında execution plan'ın hafızaya atılması bazı durumlarda kodumuza hız katabilir. Fakat bazı durumlarda da tablo yapıları veya indeksler çok sık değiştiğinden bu hafızaya atılan execution plan'lar yarar yerine zarar getirir. Bunu nasıl anlarız? ilk derlemede prosedürümüz hızlı çalışıp, sonraki çalıştırmalarda gözle görülür bir yavaşlama varsa, nedeni bu olabilir. Bundan kaçınmak için yapmamız gereken RECOMPILE keyword'unu prosedüre tanıtmak. Kısaca kullanılışı;
CREATE PROCEDURE SatisRapor
WITH RECOMPILE
AS
....Böylece Recompile yazarak, artık execution plan'ın hafızaya atılmasını engelledik.
7 Temmuz 2011 Perşembe
Sql'de Truncate Table Kavramı
Sql'de bir tablomuzda bazı verileri silmek istediğimizde, Delete komutunu kullanırız. Başka bir alternatif yokturdur. Ama tablodaki tüm kayıtları silmek istersek, hem Delete, hem Truncate komutları sayesinde tüm tabloyu boşaltabiliriz.Yani Truncate komutu da Sql'de tüm tablodaki verileri boşaltmak amacıyla kullanılır.
Peki bu iki komut arasındaki fark nedir?
Kısaca, maddeler halinde yazalım.
Peki bu iki komut arasındaki fark nedir?
Kısaca, maddeler halinde yazalım.
- Öncelikle, Truncate kavramı ile bir şarta bakmaksızın tüm tablomuzu boşaltırız. Delete komutunda Where şartı ile belli şartlara bağlayabiliriz.
- Bence en önemli farklarından birisidir şimdiki maddemiz, Truncate Table yapınca, o tablodaki identity kolonumuz en baştan başlar. Ama Delete yaparsak, en son kaçıncı id'de kalmışsa, oradan devam eder.
- Truncate Table, Transaction içerisinde kullanılırsa ve işlemimiz rollback olursa geri alınamazlar. Delete komutunda geri alabiliriz.
- Truncate Table yaptığımızda, eğer o tablo üzerinde Delete Trigger'i varsa, bu trigger tetiklenmez. Delete komutlarında ise tetiklenir.
İşte Truncate Table ile Delete komutları arasındaki en temel fark bunlardır. Son olarak da syntaxlarını, nasıl yazıldıklarını gösterelim;
- TRUNCATE TABLE Tablo1
- DELETE FROM Table1
şart koymak istersek,
- DELETE FROM Table1 WHERE ID=5
5 Temmuz 2011 Salı

İlişkili Tablolarda Veri Silme (Delete Join)
Şu ana kadar Joinleme işlemlerini ve Update Join işlemini görmüştük. Normal Joinleme işlemlerinde, birbiri ile ilişkili iki tablodan veri çekip, rahatlıkla istenilen raporu dökebiliyorduk. Daha sonra da, yine ilişkili tablolarda, gerekli şartları sağlayan kayıtları toplu halde update(Güncelleme) yapabiliyorduk. Bugün de, yine ilişkili tablolarda, belli şartları sağlayan verileri sileceğiz.
Örnek senaryomuz, AdventureWorks üzerinden AltKategorileri 'G' ile başlayan ürünleri silmek istensin bizden. Gördüğünüz gibi, tek tablo işimizi görmüyor. Product tablosundan kayıt sileceğiz ama, bu tablo üzerinden AltKategori isimlerine erişemiyoruz. İşte burada yapmamız gereken şey, iki tabloyu birleştirip, silme işlemini gerçekleştirmek. Bunun için yazmamız gereken kod şu şekilde olmalıdır;
Örnek senaryomuz, AdventureWorks üzerinden AltKategorileri 'G' ile başlayan ürünleri silmek istensin bizden. Gördüğünüz gibi, tek tablo işimizi görmüyor. Product tablosundan kayıt sileceğiz ama, bu tablo üzerinden AltKategori isimlerine erişemiyoruz. İşte burada yapmamız gereken şey, iki tabloyu birleştirip, silme işlemini gerçekleştirmek. Bunun için yazmamız gereken kod şu şekilde olmalıdır;
DELETE FROM Production.Product
FROM Production.Product p INNER JOIN Production.ProductSubcategory ps on p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.Name like 'G%'
Gördüğünüz gibi, önce hiçbir şart yokmuş gibi DELETE FROM Production.Product diyorum, daha sonra da belirtilen şartı sağlamak için joinleme işlemi yapıyorum. Bunun sonucunda, 6 kayıdın Product tablosundan silindiğini görürüz.
Not: Delete sorgusunu kullanarak, birden fazla tabloda veri silmek mümkün değildir. Bunun için birden fazla delete sorgusu çalıştırılmalıdır.
29 Haziran 2011 Çarşamba
Stored Procedure'den Başka Bir SP Çağırmak (Output Parametresi)
Bazen sql ile geliştirme yaparken, birden fazla procedure ile çalışmak zorunda kalabiliriz.Yani bir procedure'in çalışmasıyla ortaya çıkan sonucu, diğer bir procedure içerisinde kullanabiliriz. Bu tarz durumlarda, yazılım dillerindeki fonksiyon mantığıyla, o procedure'ü çağırmamız gerekir. Oradan dönen sonucu da mevcut procedure'ümüzde kullanırız.
Şimdi ufak bir senaryo üzerinden devam edersek daha iyi anlaşılacaktır. Öğrenci tablomuz olsun. ÖğrenciEkle ismindeki Stored Procedure'müz, tablomuza kayıt atsın. Ayrıca OgrenciLog tablosuna da, hangi öğrenci kayıt atılırsa, onun id'sini ekleyelim. Aslında bu örnekte birden fazla sp'ye ve tabloya gerek yok ama, sadece birbiriyle olan ilişkileri göstermek amacıyla basit bir örnek olarak düşündüm. Normalde, birbirinden bağımsız, 30-40 kolonluk bir tablo olduğunu düşünebilirsiniz...
İlk procedure'müz basit olarak insert işlemi yapacak, ardından oluşacak id'yi de output parametresi yardımıyla, dışarıya aktaracağız. Yazacağımız sp kodu şu şekilde olmalıdır.
create procedure sp_OgrenciEkle
(
@Ad nvarchar(20),
@Soyad nvarchar(20),
@No bigint,
@Okul nvarchar(20),
@Id int output
)
as
begin
insert into Ogrenci values (@Ad,@Soyad,@No,@Okul)
set @Id = SCOPE_IDENTITY()
end
Şimdi OgrenciLog tablomuzu dolduracak procedure'mizde bu id output değerini alıp, tabloya yazalım. Bunu yaparken de, "sp_OgrenciEkle" isimli procedure'u çağırmamız gerekecek. Kodlama şu şekilde olmalıdır;
alter procedure sp_OgrenciLog
as
begin
declare @Id int
exec.sp_OgrenciEkle @Ad='Ergin',@Soyad = 'Arslan', @No=1234, @Okul='YTU' , @Id = @Id output
insert into OgrenciLog (OgrenciId) values (@Id)
end
Gördüğünüz gibi exec.Procedure_Adı diyerek procedure'e eriştim ve aldığı parametreleri değerleriyle birlikte yazarak, en son da geriye döndürdüğü değeri @Id isimli değişkenimize atıp, OgrenciLog tablomuza da değeri girmiş olduk. sp_OgrenciLog tablosunu çalıştırdığımız zaman, önce sp_OgrenciEkle procedure'u çalışacak, Ogrenci tablosuna kayıt attıktan sonra oluşan id'yi Scope_Identity() ile alıp output geçerek, bizim proc'umuza atacak ve biz de o değeri OgrenciLog tablomuza atacağız.
Dediğim gibi, böyle küçük örneklerde kullanılmaz output parametresi. Birden fazla procedurelar ile, 30-40 alanlı tablolara kayıt atarken, bazı alanları, bazı sp'lerin sonucundan almamız gerekebilir. İşte bu durumlarda, yukarıdaki gibi exec.SP_Adi diyip aldığı parametreleri değerleriyle birlikte, en sonda output parametresi olacak şekilde çalıştırırsak, o proc'un döndürdüğü değeri elde etmiş oluruz.
25 Haziran 2011 Cumartesi
Sql Recursive Functions(Rekürsif Fonksiyonlar)
Recursive fonksiyonlar, kendi kendini çağıran fonksiyonlardır. C#'ta da vardır, Java'da da , C'de de. Basit bir mantık, kendi işlemini yaptıktan sonra, tekrar kendi fonksiyonunu çağırması ve tekrar kendi içinde bulunan işlemleri tekrarlamasıdır. Sql'de de böyle bir işleme ihtiyacımız olabilir. Örneğin, bir kategori kendi içinde alt kategorileri olsun, o alt kategorilerin de altında başka kategoriler daha olsun. Gördüğünüz gibi, bir hiyerarşi oluşmuş. Biz sadece bir taban altına gitmemiz, doğru bir yaklaşım olmayacaktır. En alt katmana gelene kadar, kendi kendini sürekli çağırmalı ve gerekli işlemler yapılmalıdır.
Recursive fonksiyonlara verilebilecek en klasik örnek, faktöriyel hesabıdır. 5! dediğimiz zaman, önce 5 diyecek, daha sonra kendini çağırıp 5.4 olacak, daha sonra yine kendini çağırıp 5.4.3 diye diye 0 olana kadar bu kendini çağırma işlemi devam edecek.
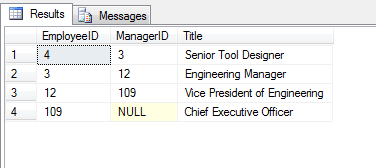
Benzer senaryo, Sql'de de karşımıza gelebilir. Örneğin, AdventureWorks veritabanı üzerinde, HumanResources.Employee tablosunda, id'si 4 olan personelin bağlı olduğu şef, o şefin bağlı olduğu diğer şef, o şefin bağlı olduğu diğer şef ... vs. Genel Müdür gelene kadar bu işlem devam etmesini istiyorsak, gördüğünüz üzere bu hiyerarşik yapıyı kullanmak için recursive fonksiyon yazmamız gerekir. Kodlama aşağıdaki gibi olmalıdır;
Recursive fonksiyonlara verilebilecek en klasik örnek, faktöriyel hesabıdır. 5! dediğimiz zaman, önce 5 diyecek, daha sonra kendini çağırıp 5.4 olacak, daha sonra yine kendini çağırıp 5.4.3 diye diye 0 olana kadar bu kendini çağırma işlemi devam edecek.
Benzer senaryo, Sql'de de karşımıza gelebilir. Örneğin, AdventureWorks veritabanı üzerinde, HumanResources.Employee tablosunda, id'si 4 olan personelin bağlı olduğu şef, o şefin bağlı olduğu diğer şef, o şefin bağlı olduğu diğer şef ... vs. Genel Müdür gelene kadar bu işlem devam etmesini istiyorsak, gördüğünüz üzere bu hiyerarşik yapıyı kullanmak için recursive fonksiyon yazmamız gerekir. Kodlama aşağıdaki gibi olmalıdır;
with CTE as
(
select EmployeeID,ManagerID,Title from HumanResources.Employee
where EmployeeID=4 --baslangic id
union all
select HE.EmployeeID,HE.ManagerID,HE.Title from HumanResources.Employee HE join CTE
on HE.EmployeeID=CTE.ManagerID
)
select * from CTE
Sonuç kümesi de aşağıdaki gibi olur;

Kodlama hakkında bilgi vermek gerekirse, öncelikle CommonTableExpression yazmamız gerekir. Bunu herhangi bir yazılım dilindeki fonksiyonlara benzetebilirsiniz. Orada o fonksiyonu sürekli çağırırken, burada da sürekli CTE ile joinlediğimiz zaman, sürekli bir üst katmana gittiğini göreceğiz. Rekürsif fonksiyonlar, ikinci sorgumuz -CTE ile join yaptığımız- boş sonuç verene kadar devam eder. Ama bu işlem ciddi performans kayıplarına yol açmaması için, Sql Server default'u olarak 100 verilmiş. Yani en fazla 100 kez bu işlem devam edecektir. Ama biz en fazla kaç kere dönmesini de değiştirebiliriz. Bunun için yazmamız gereken kod, Select * from CTE'nin sonuna
OPTION(MAXRECURSION 4)
yazmak olmalıdır.
Sql Pivotlama Kavramı
Pivotlama, kısaca satırların sütuna taşınma işlemleridir. Özellikle kurumsal firmalarda, rapor çekilirken, raporun daha okunur kılınması için veya oluşacak binlerce satırlık raporu minimize etmek için pivotlama yöntemi kullanılır. 2005 öncesi case-when yapısı kullanılarak pivotlama işlemi yapılırken, 2005 sonrası dinamik pivotlama yardımıyla artık daha kolay yapmaktayız.
Şimdi kısaca bir senaryo uydurup, beraber pivotlama yöntemiyle sorgumuzu yazalım.
Senaryomuz kısaca, AdventureWorks database'i içinde departman bazında kaç erkek, kaç bayan çalıştığını bulalım. Normal sorgulamamızı yaparsak önce departmanlara göre kaç bayan var, sonra yine departmanlara göre kaç erkek var alt alta göreceğiz, dolayısıyla satır sayısı fazla, okunulurluğu yok. Nasıl oluştuğunu görelim önce.
Sorgumuzu yazmak için 3 tabloya ihtiyacımız var. Bunlar Department, Employee ve EmployeeDepartmentHistory. Bunları birbirine joinledikten sonra cinsiyet ve departmana göre group by yapıp toplam sayı bizim istediğimiz sonuc olacak. Burada yeri gelmişken, kısaca sql'in kendi editöründen nasıl joinleme işlemlerini kolayca yapabileceğimizi göstereyim. Sorgu sayfasında herhangi bir yere sağ tıklayıp design query in editor dedikten sonra önümüze bir ekran gelecek. Add Table penceresinden yukarıda bahsettiğim üç tabloyu seçtiğimizde önümüze şu şekilde bir diyagram getirecek.

Yukarıda da görüldüğü gibi, bize sadece Gender ve Name kolonu gerektiğinden sadece onları seçiyoruz. Tabloların altında sql'in bizim için kodu kendi oluşturduğunu görüyoruz.Daha sonra oluşan kodu çalıştırdığımız zaman aşağıdaki şekilde bir sonuç kümesi geleceğiniz görürüz.

Ama biz bunu pivotlama yöntemiyle yaparsak, aşağıdaki gibi sorgu yazmamız gerekecekti. Sorgunun mantığını aşağıda anlatacağım. Önce ortaya çıkan rapor'a bakalım,

Yazacağımız kod da şu şekilde olmalıdır.
WITH CTE
as
(
SELECT Department.Name as Departman,Employee.Gender as Cinsiyet,COUNT(HumanResources.Employee.EmployeeID) [count] FROM HumanResources.Department
INNER JOIN HumanResources.EmployeeDepartmentHistory ON HumanResources.Department.DepartmentID = HumanResources.EmployeeDepartmentHistory.DepartmentID
INNER JOIN HumanResources.Employee ON HumanResources.EmployeeDepartmentHistory.EmployeeID = HumanResources.Employee.EmployeeID
group by Gender,Department.Name,Department.ModifiedDate
)
select * from CTE PIVOT (SUM([count]) for Cinsiyet in ([F],[M])) as p
Önce CommonTableExpression ile bir tablo oluşturuyoruz. Aslında bizim pivotsuz kodumuz budur. Zaten yukarıdaki resimden de query editorun yazdığı koddan karşılaştırabilirisiniz.Bu CTE'yi yazdıktan sonra bu tablodan select * from'la tüm verileri alıyoruz fakat, 2005 yılından sonra gelen PIVOT konumu ile toplam kayıt sayısına göre Cinsiyetleri üst kolona köşeli parantez içinde yazarak kolonlara taşımış oluyoruz.
Not: En sondaki yazdığımız select sorgusunun sonuna as p diyerek bir alias veriyoruz. Bu Sql'in gözden kaçırdığı veya neden böyle bir şeyi yaptırmaya mecbur tuttuğunu anlamadığım bir zorlamasıdır. Pivotlama yaptıktan sonra, yazdığımız o sorguya alias vermek zorundayız. Aksi taktirde hata mesajı verecektir. Bu yüzden rasgele bir alias verebilirsiniz, zira daha sonra herhangi bir yerde kullanılmayacaktır.
24 Mayıs 2011 Salı
Sql'de İlişkili Tablolarda Güncelleme(Update-Join)
Sql'de update işlemleri yaparken, şu ana kadar hep tek tablo üzerinden yaptık. Peki, birbiriyle ilişkili birden fazla tabloda update işlemi yaparsak nasıl bir yol izleyeceğiz?
Cevap oldukça basit. Biz yine de daha anlaşılır olması bakımından, senaryo üzerinden gidelim. İki tablomuz olsun. Öğrenci tablosunda Numara ve Ad tutulsun, Not tablosunda da ÖgrenciNo ve Puan tutulsun.
create Table Ogrenci
(
OgrenciNo int,
OgrenciAd nvarchar(20)
)
create Table Puan
(
OgrenciNo int,
Puan int
)
update Puan set Puan=50 from Puan p join Ogrenci o on p.OgrenciNo=o.OgrenciNo where OgrenciAd='Ahmet Demir'
Cevap oldukça basit. Biz yine de daha anlaşılır olması bakımından, senaryo üzerinden gidelim. İki tablomuz olsun. Öğrenci tablosunda Numara ve Ad tutulsun, Not tablosunda da ÖgrenciNo ve Puan tutulsun.
create Table Ogrenci
(
OgrenciNo int,
OgrenciAd nvarchar(20)
)
create Table Puan
(
OgrenciNo int,
Puan int
)
OgrenciNo alanı, Ogrenci tablosunda PrimaryKey iken, Puan tablosunda ForeignKey'dir. Böylece iki tabloyu ilişkilendirmiş olduk.
Birkaç kayıt girdikten sonra senaryomuz şöyle olsun. İsmi Ahmet Demir olan öğrencinin Puanını 50 yapalım. Gördüğünüz gibi tek tabloda update işlemi yapıyor olmamıza rağmen, verilen koşul başka bir tabloda. Burada iki tabloyu join ile birleştirip, ardından update işlemini yapacağız. Yazmamız gereken kod şu şekilde olmalıdır.
update Puan set Puan=50 from Puan p join Ogrenci o on p.OgrenciNo=o.OgrenciNo where OgrenciAd='Ahmet Demir'
Gördüğünüz üzere, syntax olarak, select ile yapılan joinleme işlemine çok benzer. select * from Puan ile başlayan joinleme sorgumuz, burada update Puan set Puan=50 from Puan olmuştur. Sorgu sonucunda, ismi Ahmet Demir olan öğrenci/öğrenciler 'in aldığı puanlar 50 olarak güncellenmiştir.
2 Nisan 2011 Cumartesi
@@Identity,Scope_Identity() ve IdentCurrent
Sql'de insert vs. gibi işlemler yapılırken, elde edilen Id'yi veya değişiklik yapılan Id'yi tutmak isteriz. Yani Son işlem yapılan sorgunun id'sine erişmek isteyebiliriz. Özellikle Stored Procedure'lerde veya Triggerlarda yeni eklenen öğrencinin bilgilerini farklı sorguda kullanmak isteyeceğimiz zaman, bu öğrencinin id'sine ihtiyaç duyarız. İşte bu Id'yi yakalamanın yollarını ve birbirleriyle olan farklarını anlatmaya çalışacağım şimdi.
1-@@IDENTITY:
Son işlem yapılan sorgudan elde edilen Id'yi elde etmemizi sağlar. Aşağıdaki örnekte, insert yapıldıktan sonra ortaya çıkan Id şu şekilde bulunmuştur.


3-IDENT_CURRENT('TabloAdı'):
Parametre olarak aldığı tablodaki son işlem yapılan id'nin sonucunu getirir. Kullanılışı;

1-@@IDENTITY:
Son işlem yapılan sorgudan elde edilen Id'yi elde etmemizi sağlar. Aşağıdaki örnekte, insert yapıldıktan sonra ortaya çıkan Id şu şekilde bulunmuştur.
insert into Ogrenci values ('Ergin Arslan',81,12345)
(1 row(s) affected)
dedikten sonra aşağıdaki komutu çalıştırırsak, şu çıktıyı elde ederiz;
select @@IDENTITY
@@Identity'nin dezavantajı, Trigger içerisinde kullanılamamasıdır. Bu komut yerine daha çok Scope_Identity() kullanılır.
2-SCOPE_IDENTITY:
Yukarıda da bahsettiğimiz gibi, @@Identity'den farkı, triggerlar içerisinde kullanılabilmesidir. Ayrıca, @@Identity, herhangi bir scope'dan ve tablodan bağımsız çalışır. Scope_Identity, sadece bulunduğu scope'taki id sonucunu getirir. Trigger, StoredProcedure ... vs. işlemlerde kullanılabilir. En çok tercih edilen yöntemdir. Kullanılışı;
insert into Ogrenci values ('Ergin Arslan',81,12345)
select SCOPE_IDENTITY()
3-IDENT_CURRENT('TabloAdı'):
Parametre olarak aldığı tablodaki son işlem yapılan id'nin sonucunu getirir. Kullanılışı;
insert into Ogrenci values ('Ergin Arslan',81,12345)
select IDENT_CURRENT('Ogrenci')
27 Mart 2011 Pazar
Sql'de Rollup ve Cube Kavrami
Sql’de raporlama yaparken, en cok istenen isteklerden biridir, tablonun sonunda ara toplam veya genel toplamin getirilmesi. Ornegin, AdventureWorks uzerinde, urun renklerine gore group by yapip, count ( *) ile de satilan toplam urun miktarini buluruz. Ama ornegin renklere gore de bir toplam almak istersek, bunu sadece group by fonksiyonlariyla yapamayiz.
Yellow Jerseys 4
Yellow Road Bikes 9
Yellow Road Frames 5
Yellow Touring Bikes 9
Yellow Touring Frames 9
seklinde bir cikti elde ederiz. Fakat bizim istedigimiz, yellow rengine sahip toplam kac urunun satildigi bilgisidir. Iste bunu yaparken yazdigimiz query’e with rollup komutunu eklersek, istedigimiz raporu eklemis oluruz.

Goruldugu gibi NULL yazan satir aslinda bizim rengi yellow olan urunlerimizin toplam sayisi. Yani Ara Toplam diyebiliriz. Peki cift tarafli toplam yapmak istersek..
Yapmamiz gereken tek sey with rollup yerine with cube yazmak olacaktir. Sonuc kumesinde hem renklere gore bir liste, hem de urunlere gore bir liste yapilip ara toplam belirlenecektir.
Ustteki iki ornekte soyle bir eksiklik gozumuze carpiyor. Ara toplamlarin bulundugu hucrelerde NULL yaziyor. Biz, sonuc kumesine bakarak buralarin ara toplam satiri oldugunu anliyoruz. Ama daha buyuk raporlamalarda, hem bu karisacaktir hem de kullaniciya boyle anlama zorlugu cekmek dogru bir durum degildir. Ayrica soyle bir karisiklikliga da sebep olabilir. Ornegin RoadBikes’larin renklerine gore ara toplam hazirlanirken,
RoadBikes NULL 44
oldugu zaman, ara toplam mi, renk mi veritabanindan NULL geliyor? Bunun anlasilamadigi durumlarda ciddi zararla meydana cikabilir.
Iste bu hatadan kurtulmak icin, ara toplam satirlarinda NULL yerine Ara Toplam yazmaliyiz. Grouping metotu sayesinde, eger bu satir ara toplam satiriysa, geriye 1 degerini dondurur, aksi taktirde burasi ara toplam satiri degildir. Basit bir case-when yapisiyla bunun da ustesinden gelebiliriz.
Simdi baska ornekten, hem Cube hem de grouping fonksiyonunu kullanarak daha iyi algilayalim yapmak istediklerimizi. Yine AdventureWorks veritabani uzerinden gidersek, yasadigi sehirlere gore bay ve bayan calisanlari listeleyen bir kod yazalim. Cift tarafli toplam olsun ama. Yani Seatle 30 erkek, 40 bayan vs. diye sehirlere gore erkek bayan sayilarini yazsin, en sona da toplam erkek, toplam bayan sayilari yazilsin.
Bu ornegimizde, rollup keywordunu kullanamayiz, cunku rollup ile sadece tek tarafli toplam elde ederiz. Burada kullanmamiz gereken komut, Cube’dur.
Yazacagimiz sorgu su sekilde olmalidir,
Ekran ciktisina bakarsak,

Ve en son satirda da;
NULL Genel Toplam 290 –Sehirlere gore Genel Toplam
NULL F 84
NULL M 206
Goruldugu gibi, hem sehirlere gore hem de cinsiyetlere gore toplam yapmis olduk. Grouping fonksiyonundan geriye 1 deger dondurenler icin Ara Toplam veGenel Toplam yazilarini yazdirmis olduk. Boylece ortaya cikabilecek olan yanlislarin onune gecmis olduk.
Yellow Jerseys 4
Yellow Road Bikes 9
Yellow Road Frames 5
Yellow Touring Bikes 9
Yellow Touring Frames 9
seklinde bir cikti elde ederiz. Fakat bizim istedigimiz, yellow rengine sahip toplam kac urunun satildigi bilgisidir. Iste bunu yaparken yazdigimiz query’e with rollup komutunu eklersek, istedigimiz raporu eklemis oluruz.
select PP.Color,PPS.Name,COUNT(*) from Production.Product PP inner join Production.ProductSubcategory PPS on PP.ProductSubcategoryID=PPS.ProductSubcategoryID group by PP.Color,PPS.Name with rollup
Bu kodu calistirdigimiz zaman bu sefer su sonucu almis olacagiz;

Goruldugu gibi NULL yazan satir aslinda bizim rengi yellow olan urunlerimizin toplam sayisi. Yani Ara Toplam diyebiliriz. Peki cift tarafli toplam yapmak istersek..
Yapmamiz gereken tek sey with rollup yerine with cube yazmak olacaktir. Sonuc kumesinde hem renklere gore bir liste, hem de urunlere gore bir liste yapilip ara toplam belirlenecektir.
Ustteki iki ornekte soyle bir eksiklik gozumuze carpiyor. Ara toplamlarin bulundugu hucrelerde NULL yaziyor. Biz, sonuc kumesine bakarak buralarin ara toplam satiri oldugunu anliyoruz. Ama daha buyuk raporlamalarda, hem bu karisacaktir hem de kullaniciya boyle anlama zorlugu cekmek dogru bir durum degildir. Ayrica soyle bir karisiklikliga da sebep olabilir. Ornegin RoadBikes’larin renklerine gore ara toplam hazirlanirken,
RoadBikes NULL 44
oldugu zaman, ara toplam mi, renk mi veritabanindan NULL geliyor? Bunun anlasilamadigi durumlarda ciddi zararla meydana cikabilir.
Iste bu hatadan kurtulmak icin, ara toplam satirlarinda NULL yerine Ara Toplam yazmaliyiz. Grouping metotu sayesinde, eger bu satir ara toplam satiriysa, geriye 1 degerini dondurur, aksi taktirde burasi ara toplam satiri degildir. Basit bir case-when yapisiyla bunun da ustesinden gelebiliriz.
Simdi baska ornekten, hem Cube hem de grouping fonksiyonunu kullanarak daha iyi algilayalim yapmak istediklerimizi. Yine AdventureWorks veritabani uzerinden gidersek, yasadigi sehirlere gore bay ve bayan calisanlari listeleyen bir kod yazalim. Cift tarafli toplam olsun ama. Yani Seatle 30 erkek, 40 bayan vs. diye sehirlere gore erkek bayan sayilarini yazsin, en sona da toplam erkek, toplam bayan sayilari yazilsin.
Bu ornegimizde, rollup keywordunu kullanamayiz, cunku rollup ile sadece tek tarafli toplam elde ederiz. Burada kullanmamiz gereken komut, Cube’dur.
Yazacagimiz sorgu su sekilde olmalidir,
SELECT PA.City,case when GROUPING(PA.City)=1 and GROUPING(HRE.Gender)=1 then 'Genel Toplam' when GROUPING(HRE.Gender)=1 then 'Ara Toplam' else HRE.Gender end,COUNT(*) FROM Person.Address PA INNER JOIN HumanResources.EmployeeAddress HRA ON PA.AddressID = HRA.AddressID
INNER JOIN HumanResources.Employee HRE ON HRA.EmployeeID =HRE.EmployeeID group by HRE.Gender,PA.City with cube

Ve en son satirda da;
NULL Genel Toplam 290 –Sehirlere gore Genel Toplam
NULL F 84
NULL M 206
Goruldugu gibi, hem sehirlere gore hem de cinsiyetlere gore toplam yapmis olduk. Grouping fonksiyonundan geriye 1 deger dondurenler icin Ara Toplam veGenel Toplam yazilarini yazdirmis olduk. Boylece ortaya cikabilecek olan yanlislarin onune gecmis olduk.
30 Aralık 2010 Perşembe
Sql'de Tarih Format Uyumsuzluğu
Sql'de en çok can sıkan konulardan biri de, datetime format uyumsuzluğu. Gün-ay-yıl mı olacak, ay-gün-yıl mı olacak, veya bize gönderilen dosyada daha farklı bir format varsa bunları nasıl istediğimiz formata çevirebiliriz gibi sorunlarla sürekli karşılaşmaktayız. Şimdi size, tüm tarih formatlarını içeren bir tablo ve bu formatların nasıl kullanılacağını gösteren sorguları göstereceğim.
SELECT convert(varchar, @tarih, 100) -- mon dd yyyy hh:mm
SELECT convert(varchar, @tarih, 101) -- mm/dd/yyyy
SELECT convert(varchar, @tarih, 102) -- yyyy.mm.dd
SELECT convert(varchar, @tarih, 103) -- dd/mm/yyyy
SELECT convert(varchar, @tarih, 104) -- dd.mm.yyyy
SELECT convert(varchar, @tarih, 105) -- dd-mm-yyyy
SELECT convert(varchar, @tarih, 106) -- dd mon yyyy
SELECT convert(varchar, @tarih, 107) -- mon dd, yyyy
SELECT convert(varchar, @tarih, 108) -- hh:mm:ss
SELECT convert(varchar, @tarih, 109) -- mon dd yyyy hh:mm:ss:mmm
SELECT convert(varchar, @tarih, 110) -- mm-dd-yyyy
SELECT convert(varchar, @tarih, 111) -- yyyy/mm/dd
-- yyyymmdd - ISO date format - international standard
SELECT convert(varchar, @tarih, 112) -- yyyymmdd
SELECT convert(varchar, @tarih, 113) -- dd mon yyyy hh:mm:ss:mmm
SELECT convert(varchar,@tarih, 114) -- hh:mm:ss:mmm(24h)
SELECT convert(varchar, @tarih, 120) -- yyyy-mm-dd hh:mm:ss(24h)
SELECT convert(varchar, @tarih, 121) -- yyyy-mm-dd hh:mm:ss.mmm
SELECT convert(varchar, @tarih, 126) -- yyyy-mm-ddThh:mm:ss.mmm
-- Without century (YY) date / datetime conversion
SELECT convert(varchar, @tarih, 0) -- mon dd yyyy hh:mmAM (or PM)
SELECT convert(varchar, @tarih, 1) -- mm/dd/yy
SELECT convert(varchar, @tarih, 2) -- yy.mm.dd
SELECT convert(varchar, @tarih, 3) -- dd/mm/yy
SELECT convert(varchar, @tarih, 4) -- dd.mm.yy
SELECT convert(varchar, @tarih, 5) -- dd-mm-yy
SELECT convert(varchar, @tarih, 6) -- dd mon yy
SELECT convert(varchar, @tarih, 7) -- mon dd, yy
SELECT convert(varchar, @tarih, 8) -- hh:mm:ss
SELECT convert(varchar, @tarih, 9) -- mon dd yyyy hh:mm:ss:mmm
SELECT convert(varchar, @tarih, 10) -- mm-dd-yy
SELECT convert(varchar, @tarih, 11) -- yy/mm/dd
SELECT convert(varchar, @tarih, 12) -- yymmdd
SELECT convert(varchar, @tarih, 13) -- dd mon yyyy hh:mm:ss:mmm
SELECT convert(varchar, @tarih, 14) -- hh:mm:ss:mmm(24h)
SELECT convert(varchar, @tarih, 20) -- yyyy-mm-dd hh:mm:ss(24h)
SELECT convert(varchar, @tarih, 21) -- yyyy-mm-dd hh:mm:ss.mmm
SELECT convert(varchar, @tarih, 22) -- mm/dd/yy hh:mm:ss AM (or PM)
SELECT convert(varchar, @tarih, 23) -- yyyy-mm-dd
SELECT convert(varchar, @tarih, 24) -- hh:mm:ss
SELECT convert(varchar, @tarih, 25) -- yyyy-mm-dd hh:mm:ss.mmm
Böylece bundan sonra sql'de alınan "The conversion of a varchar data type to a datetime data type resulted in an out-of-range value." vb. gibi hataların, üstteki tablodaki formatlara, belirtilen sorguları yazarak üstesinden gelebileceğiz.
Not: @tarih yerine siz de kendi tarih değişkeninizi giriniz.
